Jak jsme přestavěli Firebase Remote Config, aby byl bezpečnější, testovatelný a měl lepší podporu JSON
Firebase Remote Config se používá snadno, dokud aplikace nezačne být velká. Kopírování klíčů, rozbitý JSON, polling a sdílená nastavení pro QA dokážou z jednoduché funkce udělat překvapivě křehkou část codebase. Proto jsme naši vrstvu nad Remote Configem přestavěli na generované, reaktivní a validované API, které zachytí chyby už při buildu a dává vývojářům i QA mnohem bezpečnější způsob práce s konfigurací.
Všimli jsme si, že naše Android aplikace nevyužívá real-time aktualizace Firebase Remote Configu. Místo toho si opakovaně stahovala konfigurační hodnoty a pomalu se blížila k rate limitům Firebase. To otevřelo dveře k tomu hodit oko na to, jak máme celkový remote config zpracovaný, a případně ho zlepšit.
Tohle je příběh o tom, co jsem postavil a proč: generátor kódu, který z obyčejného Kotlin interface vytvoří validovanou, reaktivní a pro QA přívětivou vrstvu nad Remote Configem.
Co bylo špatně
Raw Android API Firebase Remote Configu vypadá docela nevinně:
val enabled = remoteConfig.getBoolean("cool_new_feature")Ale ve velkých multimodulárních aplikacích přestane být jednoduchý dokonce i Remote Config:
-
Klíče nejsou zaručeny. Identifikátory jednotlivých remote config hodnot (klíče) závisí na domluvě mezi platformami a kopírování/přepsání. Překlep nebo pozdější změna bez problémů projde kompilací a tiše vrátí výchozí hodnotu. Nikdo si ničeho nevšimne, dokud se funkce záhadně nikdy nezapne.
-
Neexistuje jeden zdroj pravdy. Klíče žijí ve Firebase Console, v XML souboru s defaulty a na různých místech v kódu. Časem se tyto tři zdroje začnou rozcházet. Klíče zmizí z konzole, ale zůstanou v kódu. Jiné se přidají do kódu, ale nikdo pro ně nevytvoří default. A nic vás na to neupozorní.
-
Není to reaktivní. Jednotlivá místa v kódu volají get na hodnotu, kdy ji chtějí. Neexistuje žádný tok dat, který znovu emituje hodnotu ve chvíli, kdy Firebase pošle aktualizaci. Každé místo by muselo observing dělat samostatně. To se hlavně může projevit v home screenu, kde aktualizace hodnot po otevření appky může pár sekund trvat.
-
Složitější typy se řeší ručně. Konfigurační hodnoty zakódované jako JSON objekty se deserializují vždy stejným stylem a každé místo v kódu řeší chyby jinak.
Problém s parsováním JSONu
Remote Config zná stringy, ne naše objekty. JSON hodnota ve Firebase Console je z pohledu Firebase pořád jen string, takže rozbitý JSON je pro Firebase naprosto validní hodnota. Někdo upraví JSON konfiguraci v konzoli, vynechá závorku, vytvoří neplatný JSON, klikne na Publish a Firebase ho pošle do každého zařízení.
Možná si říkáte: „Dobře, parsing selže, tak použijeme default zabalený v aplikaci.“ Jenže nemůžete. API vám zpřístupní jen poslední staženou hodnotu. Jakmile existuje stažená hodnota, in-app default už není dostupný. Neexistuje možnost „místo toho mi dej XML default“. To končí dáváním default hodnot do error handlingu každé hodnoty zvlášť, následné změny default hodnot ve Firebase se ale nepropíšou automaticky.
Každý seriózní wrapper/tooling proto musí vyřešit oba problémy: za běhu při selhání parsování přejít na default a zároveň už při buildu garantovat, že samotný default lze správně naparsovat. Jen tak bude fallback vždy fungovat.
Proč jsme prostě nepoužili existující knihovnu?
Third-party knihovny vždycky pokrývaly jen část toho, co jsme potřebovali. Žádná nepokrývala všechno a žádná neřešila problém s parsováním JSONu. KFirebaseRemoteConfig je například skvělá knihovna, ale její API pořád nabízí volání getString(key): slabě typovaná, nereaktivní a bez validace defaults při kompilaci.
Zvažovali jsme i méně sofistikovanou cestu: extension functions, konvence nebo třeba dobře napsaná pravidla pro AI. Jenže konvence nic nevynucují. Přenášejí odpovědnost na code review a disciplínu vývojářů, tedy přesně tam, kde původní problémy vznikly.
A nedají vám ani jednu z věcí, která se nakonec ukázala jako mimořádně užitečná: generovanou debug obrazovku, na které vývojáři a QA vidí každý config klíč, který aplikace skutečně používá, jeho raw remote hodnotu a mohou si kterýkoli klíč lokálně přepsat.
Dříve testování scénářů závislých na konfiguraci znamenalo měnit hodnoty ve sdílené Firebase Console. Testeři si tak neustále šlapali na nohy. Jeden člověk přepne flag kvůli scénáři A a někomu jinému se uprostřed testování rozbije scénář B. S lokálními overrides může každý tester spouštět vlastní scénáře paralelně na svém zařízení, zatímco konzole zůstane nedotčená.
To vám žádná konvence nezařídí. Takže jsme šli cestou codegenu.
Řešení: nadefinujte interface, zbytek se vygeneruje
Výsledkem je malý kus infrastruktury postavený na dvou nástrojích: KSP (Kotlin Symbol Processing), který analyzuje anotovaný kód při kompilaci, a KotlinPoetu, knihovně od Square pro generování Kotlin source files. Místo skládání generovaného kódu ze stringů KotlinPoet pracuje s řádným modelem Kotlin typů, funkcí a properties. Díky tomu zůstává samotný generátor čitelný a udržovatelný.
Vývojář napíše jen toto:
@RemoteConfigSource
internal interface FeatureRemoteConfig {

    @RemoteConfigProperty("cool_new_feature")
    val coolNewFeatureEnabled: StateFlow<Boolean>

    @RemoteConfigProperty("feature_rules")
    val featureRules: StateFlow<FeatureRules?>
}
A k tomu jednu položku pro každý klíč ve standardním Firebase XML souboru s defaulty – tedy ve stejném souboru, který Firebase stejně načítá za běhu:
<entry><key>cool_new_feature</key><value>false</value></entry>
<entry><key>feature_rules</key><value>{"rules":[]}</value></entry>
Všechno ostatní vznikne automaticky při kompilaci: implementační třída, metadata pro debug panel i validační logika. Přidání nové konfigurační hodnoty znamená jednu property v interface a jednu položku v XML. Rychlé a bezpečné.
Build vás zastaví dřív, než rozbitou konfiguraci pošlete do produkce
XML soubor s defaulty má dvojí roli. Firebase ho za běhu načítá jako zdroj výchozích hodnot a KSP processor ho při kompilaci používá jako základ pro validaci. Každý deklarovaný klíč musí v XML existovat a každý default musí jít naparsovat do deklarovaného typu.
Překlep v klíči? Build selže. Boolean default, který není přesně true nebo false? Build selže. Neplatný JSON v defaultu? Build selže. Duplicitní klíč v XML? Build selže. Celá jedna třída runtime problémů se mění v chyby při kompilaci a chybová hláška vám přesně řekne, který klíč je špatně a proč.
Tím se řeší i problém s parsováním JSONu. Protože jsme už při buildu ověřili, že default lze správně naparsovat, runtime na něj může vždy bezpečně přejít. Když Firebase pošle rozbitý JSON, vygenerovaný kód chybu zaloguje a flow dál emituje hodnotu, se kterou si aplikace poradí – bez pádů a improvizovaného null handlingu na jednotlivých call sites.
Pro vlastní typy označené @Serializable platí jedno záměrné pravidlo: musí být nullable. A není to konvence, kterou si musíte pamatovat. Processor ji vynucuje. Když deklarujete StateFlow<FeatureRules> místo StateFlow<FeatureRules?>, build selže a vysvětlí vám, že typ musí být nullable, protože deserializace může za běhu selhat.
Default se ověřuje při buildu, ale remote hodnota se pořád může odchýlit od očekávaného schématu. V takovém případě property vrátí null místo pádu aplikace. Každý konzument sice musí umět s null pracovat, ale to je failure mode, který codebase už zná.
Reaktivní už od základu a sbohem, rate limity
Každá vygenerovaná property je StateFlow. Okamžitě emituje aktuální hodnotu a znovu ji emituje ve chvíli, kdy Firebase pošle aktualizaci nebo se změní lokální override. Konzumenti jednoduše collectují flow. Žádný polling.
Pod kapotou existuje pro celou aplikaci přesně jeden Firebase real-time update listener. Ten napájí sdílený invalidation bus používaný všemi odvozenými flows, takže jediná pushnutá aktualizace znovu vyhodnotí všechny dotčené hodnoty v celé aplikaci a všechno zůstane synchronizované.
Tím se řeší i původní problém. Opakované fetchování zmizelo a s ním i riziko rate limitů. Jedno živé spojení, spousta flows, žádný polling.
Lokální overrides bez vedlejších efektů
Debug panel s overrides se generuje ze stejných metadat jako zbylé vrstvy. Zobrazuje všechny zdroje a klíče, jejich typ, default a aktuální remote hodnotu. Lokální override můžete nastavit podle stejných pravidel parsování jako skutečnou konfiguraci, takže při neplatné hodnotě systém bezpečně přejde na fallback místo toho, aby aplikaci rozbil.
Panel existuje jen v debug buildech. Build type vybírá mezi dvěma implementacemi override storu: verzí postavenou nad DataStore pro debug a no-op implementací pro release. Resolution engine i generovaný kód jsou jinak v obou typech buildu stejné. V release overrides jednoduše nikdy neexistují. Žádné debug chování se tak nedostane do produkce.
Nejtěžší část: testování generovaného kódu
Postavit samotný generátor byla ta jednoduchá část. Pořádně ho otestovat bylo těžší.
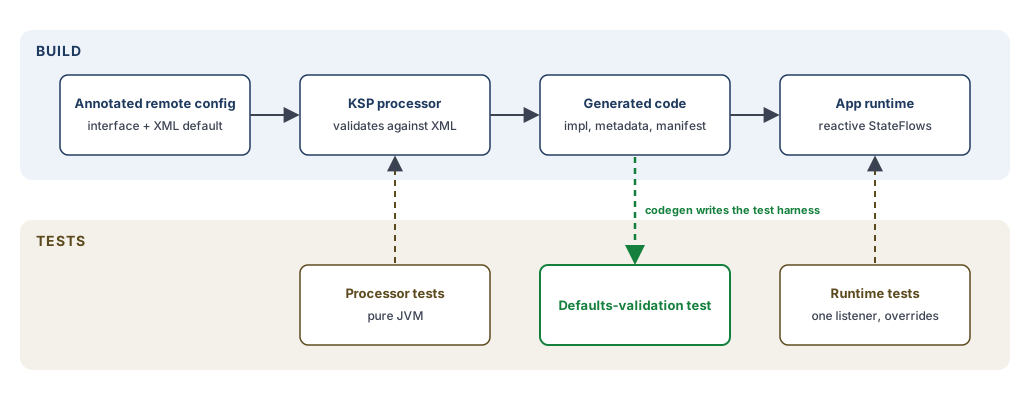
Celá funkce totiž nežije na jednom místě. Prochází několika fázemi buildu a testovací pipeline. KSP processor běží při kompilaci na JVM, tedy ještě předtím, než aplikace vůbec existuje. Vygenerovaný kód běží uvnitř aplikace. Validace defaultů běží v unit testech. A každá fáze má přístup jen k části systému: processor nevidí běžící aplikaci, unit testy nemohou znovu spustit processor a runtime engine nic neví o XML souboru.
Každá fáze proto potřebovala vlastní testovací strategii: unit testy parsování v processoru, resolution typů a generování kódu, testy runtime resolution a chování listeneru včetně ověření, že existuje jen jeden Firebase listener bez ohledu na počet flows, a test validace defaultů, který běží proti skutečnému vygenerovanému výstupu.
Nakonec se celý systém udržuje sám. Processor spolu s generovaným kódem vytváří ServiceLoader manifest a jeden jediný test přes něj objeví všechny config sources a ověří jejich defaulty. Když kdekoli v aplikaci přidáte nový source, nemusíte upravit ani jeden test. Nový source se automaticky najde a zvaliduje. Testy, které se udržují samy, jsou mnohem lepší než testy, které musíte udržovat vy.
Co se vlastně změnilo
Měřitelná část je jednoduchá: přidání nové config hodnoty dříve znamenalo upravovat několik míst v kódu, ručně řešit parsing a doufat. Teď jde o jednu property v interface a jednu položku v XML a compiler vaši práci zkontroluje. Polling i s rizikem rate limitů zmizel a nahradil ho jediný real-time listener.
Ještě důležitější se ale ukázaly věci, které se měří hůř. QA má teď přehled: override panel v reálném čase ukazuje přesně ty klíče, které aplikace skutečně používá. Když nějaký flag ještě není implementovaný nebo už byl odstraněný, testeři to vidí sami, bez ptaní vývojáře. A protože jsou overrides lokální, několik testerů může současně testovat různé scénáře bez toho, aby bojovali o jednu sdílenou Firebase Console.
Po několika měsících si nejvíc ceníme toho, že bezpečnost není konvence, kterou si někdo musí pamatovat. Je součástí samotné struktury systému. Překlepy, rozbité defaulty nebo chybějící error handling selžou včas, QA může testovat nezávisle a aplikace už kvůli aktualizacím nepolluje. To je skutečný přínos: méně pravidel, která si lidé musí pamatovat, a víc záruk, které vynucuje samotný systém.
Pokud udržujete rozsáhlejší Remote Config postavený nad raw Firebase API, doporučili bychom stejný směr: správnost nevynucovat konvencemi, ale buildem.
